
Печатный текст превращается в текст, который можно править
Распознавание читает печатный текст с выбранных изображений или отсканированных страниц и выводит результат на экран, где его можно поправить перед использованием.
- Выберите изображения или один PDF
- Распознайте печатный текст на устройстве
- Поправьте результат перед использованием
- Скопируйте или отправьте текст
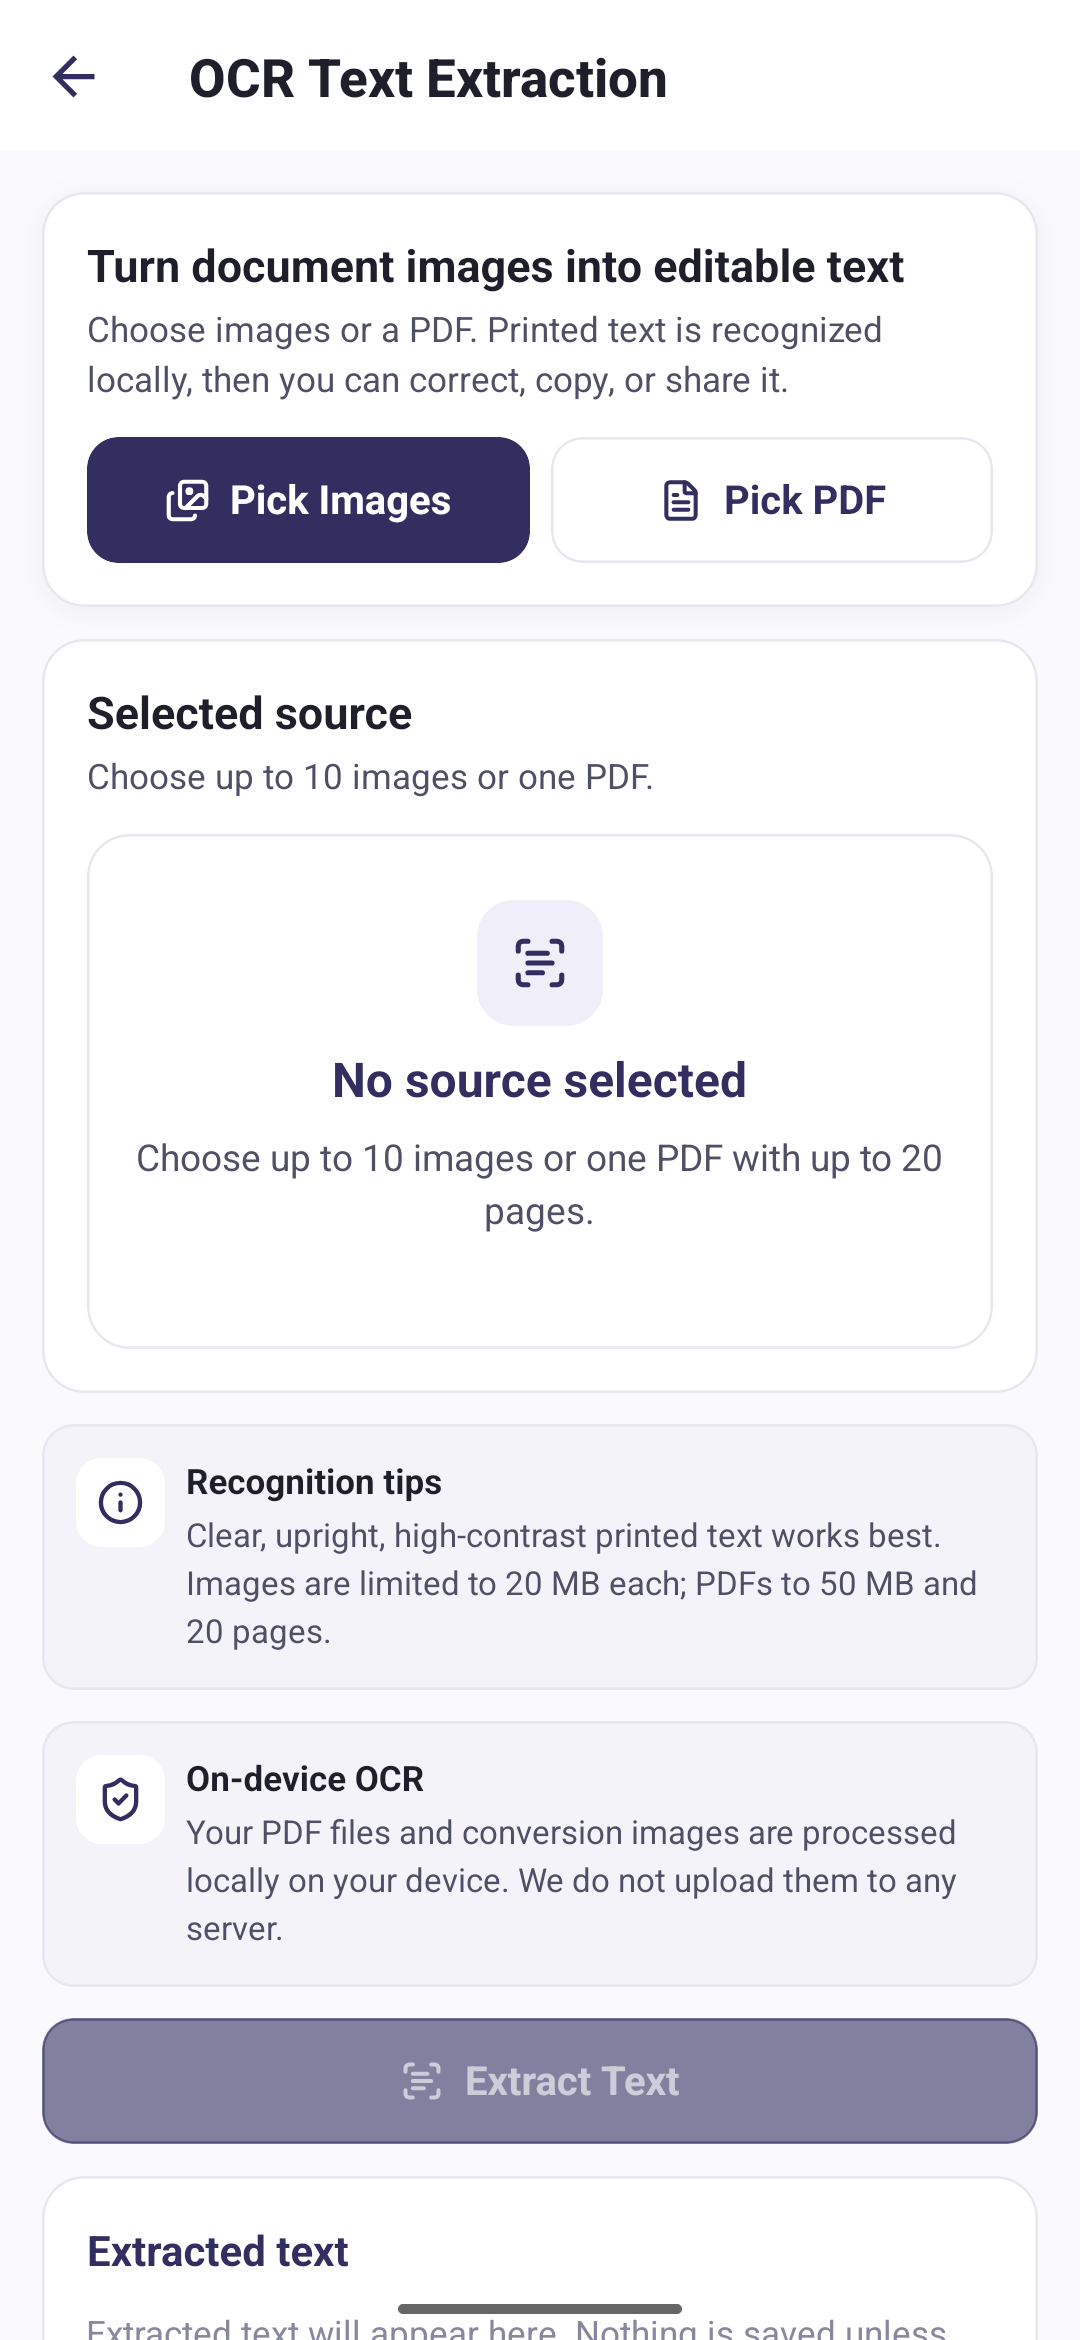
Три шага от скана к тексту
Выберите источник
Возьмите до десяти изображений или один PDF не длиннее двадцати страниц.
Распознайте
Текст распознаётся на вашем телефоне, страница за страницей.
Используйте текст
Поправьте то, что распознано неверно, затем скопируйте или отправьте.
Что принимается
Эти ограничения задаёт само приложение, так что о них стоит знать заранее:
- До 10 изображений за раз или один PDF
- До 20 страниц в PDF
- До 20 МБ на изображение
- До 50 МБ для PDF
- PDF не должен быть защищён паролем
Ничего не сохраняется, пока вы не попросите
Распознанный текст появляется в поле, которое можно править. Он не добавляется в «Мои файлы» и не остаётся после очистки: экран он покидает, только если вы скопируете его в буфер обмена или отправите. При отправке создаётся временный текстовый файл, передаётся в меню отправки Android и затем удаляется.
Распознавание идёт на вашем телефоне
Ваши PDF-файлы и конвертированные изображения обрабатываются локально на вашем устройстве. Мы не загружаем их ни на какой сервер.
Превратить изображения в PDF
Импортировать и упорядочить существующие PDF
Вопросы о распознавании текста
Краткие ответы об этой возможности PDF Tools.
Нужен ли для распознавания интернет?
Нет. Модель распознавания поставляется внутри приложения, поэтому распознавание идёт на вашем устройстве и работает без интернета. Ваши изображения, ваши PDF и распознанный текст никогда не выгружаются. Компонент Google ML Kit, который выполняет распознавание, отправляет в Google базовые диагностические данные о себе, но никогда не ваше содержимое, как поясняется в Политике конфиденциальности.
Создаёт ли оно PDF с возможностью поиска?
Нет. На выходе обычный текст, который можно править, копировать или отправлять. Приложение не записывает распознанный текст обратно в PDF.
Какие языки оно может читать?
В приложение встроена модель распознавания латиницы, поэтому оно читает печатный текст на этой письменности. Выбора языка нет, и распознанное оно не переводит.
Читает ли оно рукописный текст?
Оно сделано для печатного текста. Лучший результат даёт чёткий, ровный, контрастный печатный текст.
Сохраняется ли распознанный текст где-нибудь?
Нет, пока вы сами что-то с ним не сделаете. Текст остаётся на экране результата, пока вы не скопируете или не отправите его, и в «Мои файлы» не попадает.