
文字识别能做什么
印刷文字,变成你能编辑的文字
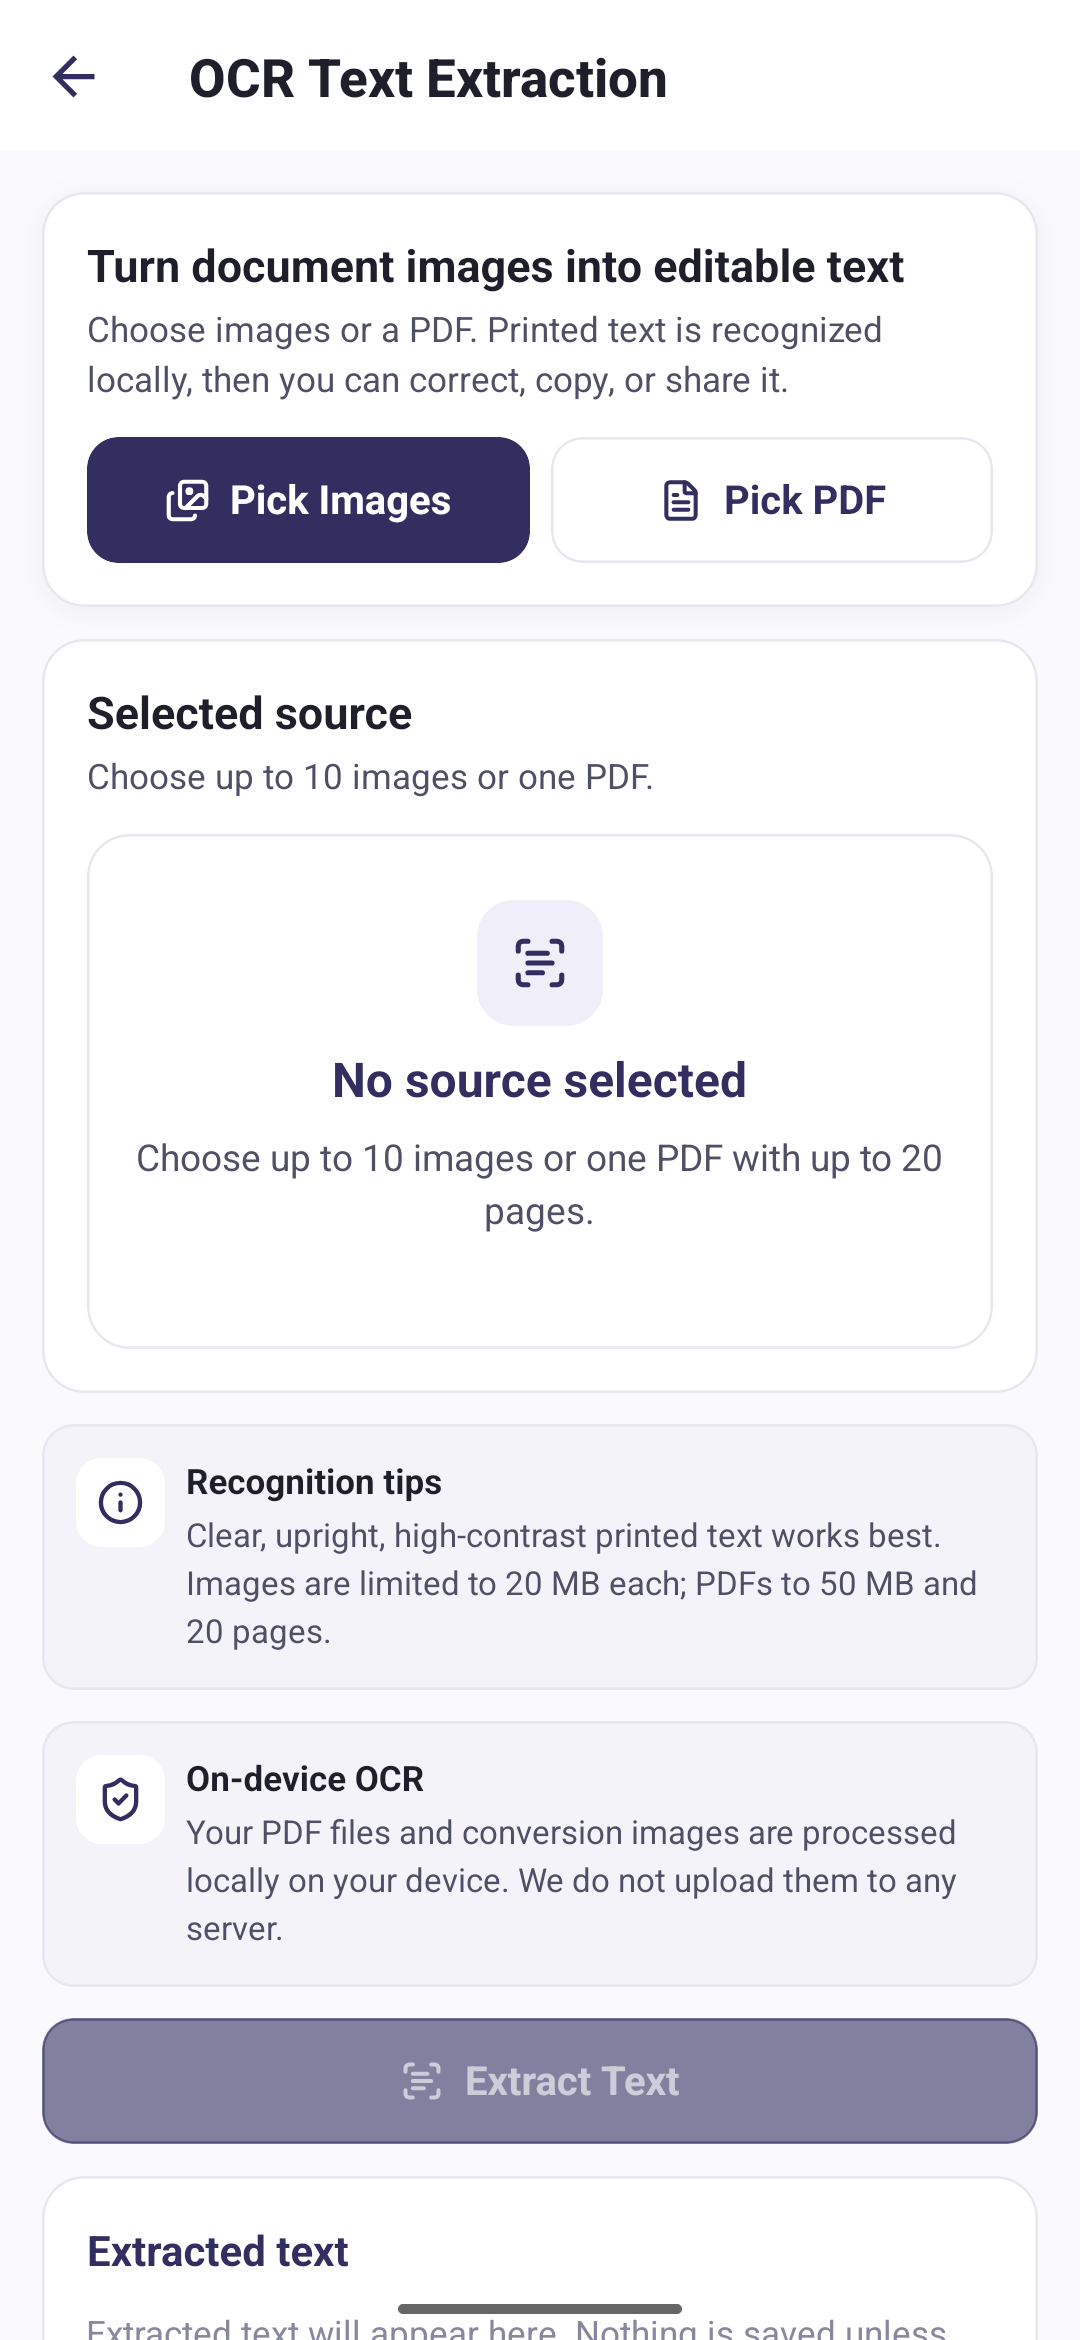
OCR 会从你选的图片或扫描页面中读取印刷文字,并把结果放到屏幕上,你可以在使用前先改一改。
- 选择图片或一个 PDF
- 在设备上识别印刷文字
- 使用之前先修改结果
- 复制或分享这些文字
怎么用
三步从扫描件到文字
选择来源
最多十张图片,或者一个不超过二十页的 PDF。
提取
文字在你的手机上逐页识别。
使用文字
把识别错的地方改好,然后复制或分享。
限制
能接受什么
这些限制是应用本身设定的,开始之前知道一下比较省事:
- 一次最多 10 张图片,或者一个 PDF
- PDF 最多 20 页
- 每张图片最大 20 MB
- PDF 最大 50 MB
- PDF 不能设有密码
结果
除非你主动操作,否则什么都不会保存
识别出的文字会出现在一个可编辑的框里。它不会加入“我的文件”,清空后也不会留下:只有当你把它复制到剪贴板或者分享出去时,它才离开这个屏幕。分享时会写出一个临时文本文件,交给安卓的分享菜单,然后再删掉。
常见问题
关于文字识别的问题
关于 PDF Tools 这项功能的直接回答。
OCR 需要联网吗?
不需要。识别模型就装在应用里,所以文字识别在你的设备上运行,离线也能用。你的图片、PDF 和识别出的文字都不会被上传。负责识别的 Google ML Kit 组件会向 Google 发送关于其自身的基本诊断信息,但绝不会发送你的内容,隐私政策中对此有说明。
它会生成可搜索的 PDF 吗?
不会。输出是纯文字,你可以编辑、复制或分享。应用不会把识别出的文字写回 PDF 里。
它能读哪些语言?
应用内置了拉丁字母的识别模型,所以它读取用拉丁字母印刷的文字。没有语言选择,也不会翻译识别到的内容。
它能认手写体吗?
它是为印刷文字做的。清晰、端正、明暗对比分明的印刷文字效果最好。
识别出的文字会保存在什么地方吗?
除非你主动处理,否则不会。文字会留在结果屏幕上,直到你复制或分享,它不会加入“我的文件”。